而在大模型技术落地过程中,上述需求其实不在少数,基于 CPU
的推理方案无疑是一种更具性价比的选择。不仅能够满足其业务需求,还能有效控制成本、保证系统的稳定性和数据的安全性。但这也就愈发让我们好奇,作为通用服务器,CPU
在 AI 时代可以发挥怎样的优势?其背后的技术原理又是什么?
1、AI 时代,CPU 是否已被被边缘化?
提起 AI 训练和 AI 推理,大家普遍会想到 GPU 更擅长处理大量并行任务,在执行计算密集型任务时表现地更出色,却忽视了 CPU 在这其中的价值。
AI 技术的不断演进——从深度神经网络(DNN)到 Transformer 大模型,对硬件的要求产生了显著变化。CPU
不仅没有被边缘化,反而持续升级以适应这些变化,并做出了重要改变。
AI 大模型也不是只有推理和训练的单一任务,还包括数据预处理、模型训练、推理和后处理等,整个过程中需要非常多软硬件及系统的配合。在 GPU 兴起并广泛应用于
AI 领域之前,CPU 就已经作为执行 AI
推理任务的主要硬件在被广泛使用。其作为通用处理器发挥着非常大的作用,整个系统的调度、任何负载的高效运行都离不开它的协同优化。
此外,CPU 的单核性能非常强大,可以处理复杂的计算任务,其核心数量也在不断增加,而且 CPU 的内存容量远大于 GPU 的显存容量,这些优势使得 CPU
能够有效运行生成式大模型任务。经过优化的大模型可以在 CPU 上高效执行,特别是当模型非常大,需要跨异构平台计算时,使用 CPU
反而能提供更快的速度和更高的效率。
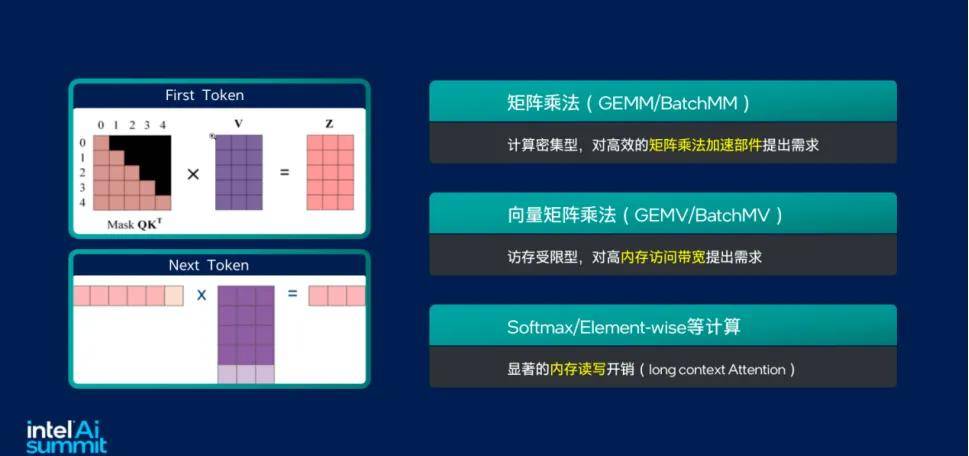
而 AI 推理过程中两个重要阶段的需求,即在预填充阶段,需要高算力的矩阵乘法运算部件;在解码阶段,尤其是小批量请求时,需要更高的内存访问带宽。这些需求 CPU
都可以很好地满足。
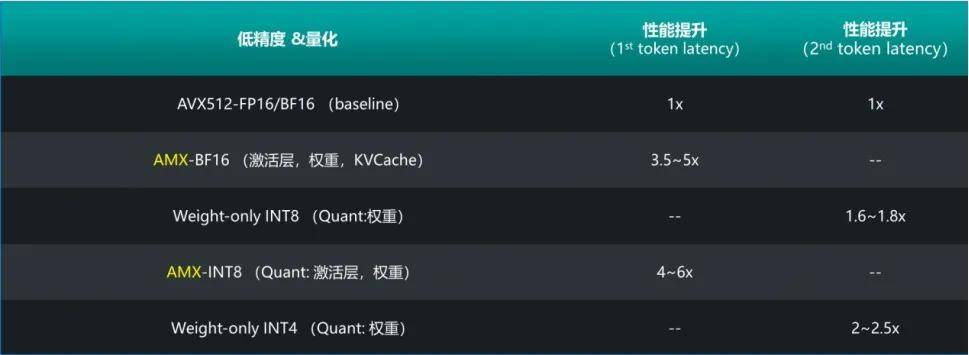
以英特尔举例,从 2017 年第一代至强® 可扩展处理器开始就利用英特尔® AVX-512 技术的矢量运算能力进行 AI 加速上的尝试;再接着第二代至强®
中导入深度学习加速技术(DL Boost);第三代到第五代至强® 的演进中,从 BF16 的增添再到英特尔® AMX 的入驻,可以说英特尔一直在充分利用 CPU
资源加速 AI 的道路上深耕。
CPU 不仅是企业解决 AI 算力焦虑过程中的重要选项,更是企业追求“效价比”的优选。在大模型技术落地的“效价比”探索层面上,百度智能云和英特尔也不谋而合。
百度智能云千帆大模型平台(下文简称“千帆大模型平台”)作为一个面向开发者和企业的人工智能服务平台,提供了丰富的大模型,对大模型的推理及部署服务优化积攒了很多作为开发平台的经验,他们发现,CPU
的 AI 算力潜力将有助于提升 CPU 云服务器的资源利用率,能够满足用户快速部署 LLM 模型的需求,同时还发现了许多很适合 CPU 的使用场景:
●对首 Token 时延不敏感,更注重整体吞吐的离线批量推理场景:这类场景通常要求系统能够高效处理大量的数据,而 CPU
的强大计算能力和高吞吐量特性可以很好地满足要求,能够确保推理任务的快速完成。
英特尔的测试数据也验证了千帆大模型平台团队的发现,其通过测试证明,单台双路 CPU 服务器完全可以轻松胜任几 B 到几十 B 参数的大模型推理任务,Token
生成延时完全能够达到数十毫秒的业务需求指标,而针对更大规模参数的模型,例如常用的 Llama 2-70B,CPU
同样可以通过分布式推理方式来支持。此外,批量处理任务在 CPU 集群的闲时进行,忙时可以处理其他任务,而无需维护代价高昂的 GPU
集群,这将极大节省企业的经济成本。